如果你跟我一樣,喜歡用自己的筆電顯卡(像是常見的 RTX 4050 6GB)在本機透過 llama.cpp 跑 AI 大模型,最近可能常在社群看到一個超神名詞——MTP(Multi-Token Prediction,多目標投機解碼)。
網路上各種教學都說:「開了 MTP / 投機解碼,生成速度(t/s,每秒產出字數)能直接飛天起跳!」
聽起來超香對吧?但當我興致沖沖在我的 RTX 4050 上跑起 Gemma-4 12B,甚至外掛了 MTP Draft 模型之後……
實測結果直接給我當頭一棒:
- ❌ 開了 MTP:速度掉到只剩 1.3 ~ 6.2 t/s(卡到懷疑人生)
- ⭕ 關掉 MTP(純跑主模型):速度瞬間飆到 32.5 t/s!(流暢像打字機一樣)
等等,說好的科技魔法呢?為什麼照著大家說的「加速黑科技」去開,速度反而暴跌了十幾倍?
今天這篇文章就用最白話的日常比喻,聊聊為什麼在 RTX 4050 這種入門顯示卡上,MTP 不但不會變快,反而是在扯後腿!
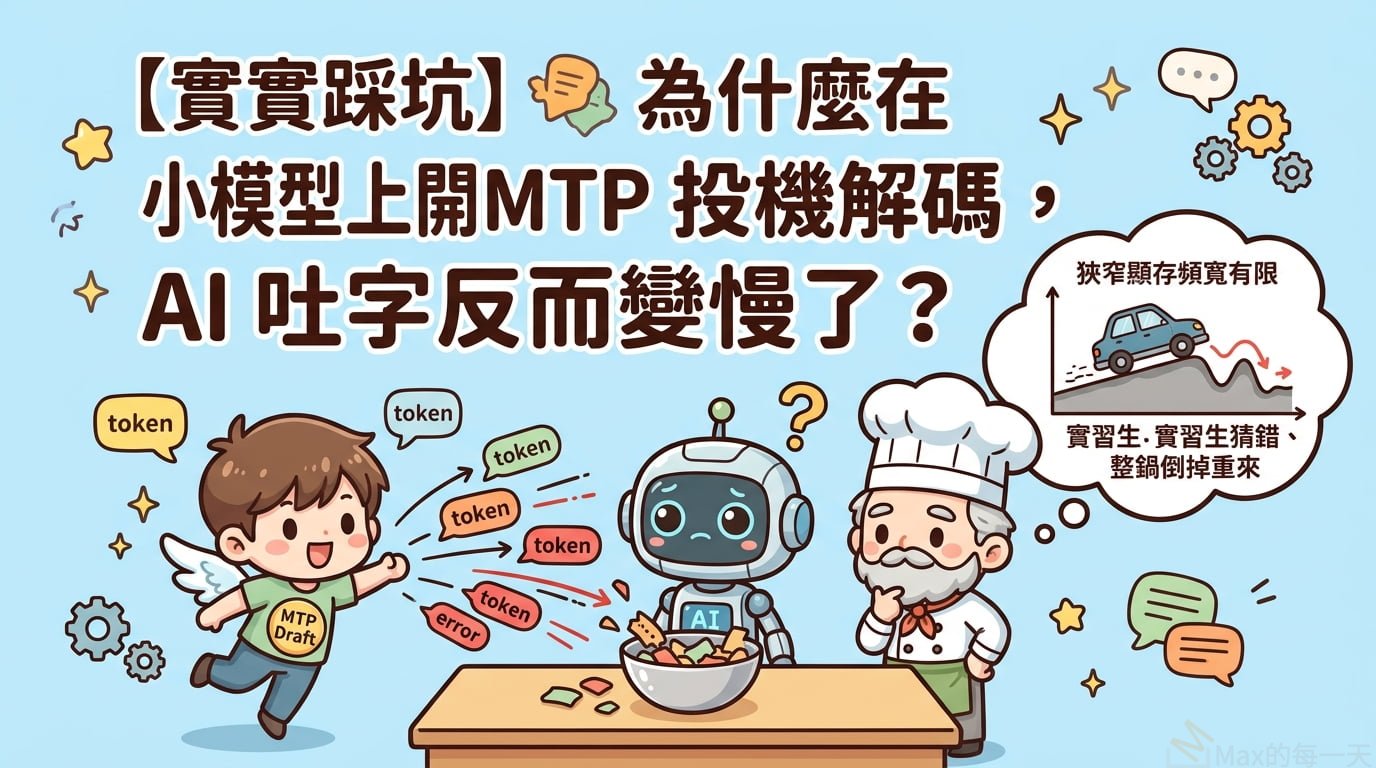
什麼是 MTP 投機解碼?用「大廚與實習生」秒懂!
一般 AI 寫字(生成 Token)的過程,就像一個超厲害的大主廚,每炒好一道菜(吐出一個詞),就必須停下來嚐一口、思考下一步,再炒下一道。
而所謂的 MTP / 投機解碼,就是老闆在大廚旁邊配了一個**「動作很快的實習生(Draft 輔助模型)」**:
- 實習生搶先猜:「主廚,我覺得你接下來會想放鹽、放胡椒、再放蔥花對吧?我先幫你倒進去!」(實習生一口氣猜好幾個詞)
- 大廚一口氣驗收:大廚回頭看一眼,如果實習生全部猜對,大廚直接蓋章通過!一次跳過好幾道工序,瞬間省下超多時間!
那為什麼在 RTX 4050 上,這套加速法直接大翻車?
如果你把這個「實習生 + 主廚」的組合,搬到像是 H100 伺服器級神卡、或者主廚是 70B(超巨無霸模型) 的情況下,因為大廚自己做一道菜太久了,只要實習生矇對一次,就賺翻了。
但在我們的小筆電 RTX 4050 上,情況完全不一樣:
1. 廚房走道太窄了!(顯存頻寬有限)
RTX 4050 是一張 6GB 顯存、頻寬只有 96-bit 的小卡。
平常只要主廚一個人工作,廚房走道剛剛好;現在硬塞了一個實習生進來,兩個人要在狹小的廚房裡擠來擠去互相遞東西。光是兩人切換、搬運資料(Hidden State / 顯存讀寫)花的時間,就已經把廚房塞爆了!
2. 主廚自己本來就動作飛快!(輕量量化模型算力很充裕)
我們這次跑的 Gemma-4 12B 經過了量化(IQ3_XXS),主廚本人其實是「閃電快炒手」——不靠實習生,自己順順炒就能炒出 32.5 t/s 的極高速度,根本不需要別人多管閒事。
3. 實習生一猜錯,整鍋倒掉重來!(猜測與驗證懲罰太重)
如果實習生猜了 10 個動作,結果第 2 個就猜錯了:
- 後面猜的 8 個動作全部白費作廢!
- 大廚還要親自停下手邊動作,把爛攤子收拾乾淨,重新自己炒一次。
也就是說:「實習生在那邊瞎猜 + 大廚停下來審查」所浪費的時間,遠遠超過了大廚自己順順炒的時間! 這就是為什麼速度會從 32 t/s 慘跌到剩下 1~6 t/s 的最大元兇。
快速優缺點大評比
| 方案 | Plan A:純本體模式(關閉 MTP) | Plan B:開 MTP 投機模式 |
|---|---|---|
| 打字速度 (t/s) | 🚀 ~32.5 t/s(快又穩) | 🐢 ~1.3 ~ 19 t/s(被猜測嚴重拖慢) |
| 6GB 顯存吃水 | 輕鬆容納,約 5.2GB 顯存 | 極限緊繃,剩幾百 MB,對話長了容易卡死 |
| 系統複雜度 | 單純穩定,不會遇到奇怪的相容性報錯 | 容易撞到 llama.cpp 新版的 Graph 斷言或 Slot 衝突 |
| 推薦度 | ⭐⭐⭐⭐⭐ (日常使用首選) | ⭐⭐(適合寫報告或做學術實驗) |
結論與新手指南
科技圈很多高大上的技術名詞(像 Speculative Decoding、MTP 等),背後都有它們特定的適用場景。
- 什麼時候適合開 MTP?
- 你跑的是 70B 甚至更大規模、本體速度原本不到 5 t/s 的巨無霸模型。
- 你的顯卡頻寬巨大、算力過剩(例如高階桌機顯卡或工作站)。
- 什麼時候果斷關掉 MTP?
- 用的是筆電卡(如 RTX 4050 / 4060 筆電版)。
- 跑的是 8B / 12B / 14B 等中小型輕量量化模型。
一句話總結:
如果你的主模型本來就能跑出 20~30+ t/s,「簡簡單單就是快」,果斷關閉 MTP,省下顯存讓上下文更長,享受絲滑不卡頓的對話體驗吧!